Quando um agente de programação precisa alterar uma função num repositório que ele não escreveu, a primeira coisa que faz é tentar descobrir quem depende dela. Ele busca o nome por texto, abre alguns arquivos, lê o que cabe no contexto e, a partir disso, monta para si uma imagem da estrutura. Essa imagem nunca aparece como artefato. Ela vive dentro do raciocínio do modelo, misturada com o plano de mudança, e chega ao usuário já convertida em decisão: «posso alterar isso, só há dois chamadores». Se havia um terceiro chamador num módulo que a busca não alcançou, ou uma referência por reexportação que o texto não denunciava, o erro não aparece como erro de leitura. Aparece como bug, depois. Para mim, esse é o ponto cego que justifica o TCG: o problema não está em o modelo raciocinar mal, está em o modelo raciocinar sobre fatos que ele mesmo improvisou no caminho, sem que ninguém consiga distinguir o que foi observado do que foi suposto.
O TCG (Traceability-Guided Change Governance) é a minha tentativa de tirar essa imagem de dentro do raciocínio e transformá-la em infraestrutura. Ele analisa o repositório de forma determinística e constrói um mapa consultável de arquivos, símbolos, definições, referências, chamadas (quando suportadas), dependências, proveniência e possíveis impactos estruturais. O consumidor desse mapa é um agente baseado em LLM. Hoje publiquei no LinkedIn uma delimitação curta do projeto; aqui quero tratar do que ela implica, porque a delimitação não é modéstia de apresentação. É a decisão de arquitetura.
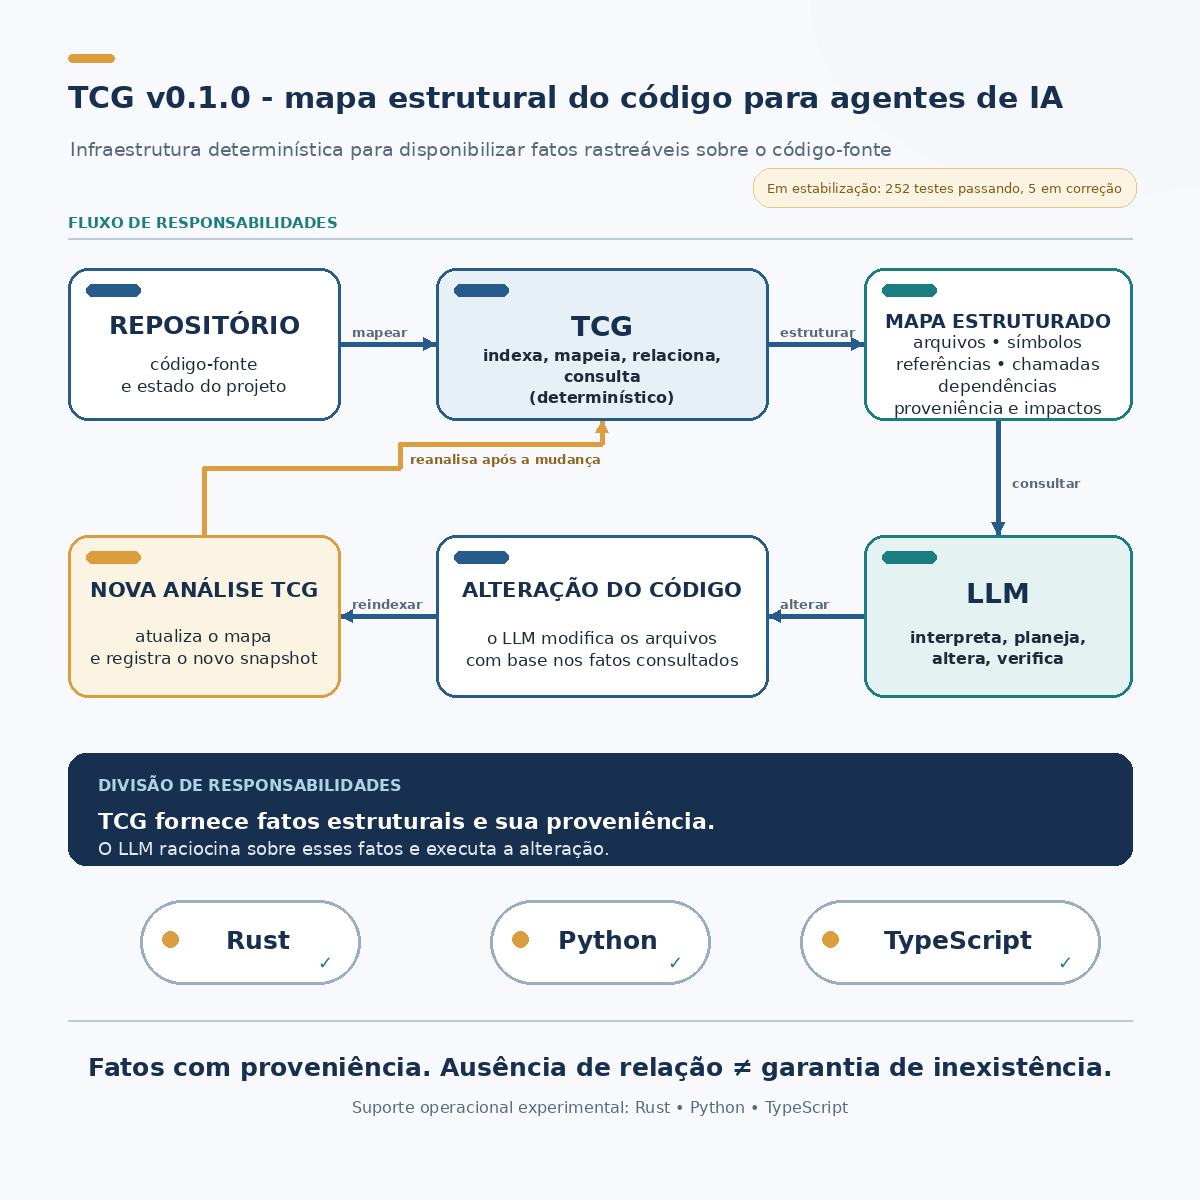
Fato de um lado, raciocínio do outro
A tentação óbvia, quando se tem um mapa do código, é fazê-lo agir. Se o sistema sabe quem chama quem, por que não sugerir o patch? Se sabe o impacto, por que não escolher a estratégia? Eu recusei esse caminho deliberadamente. O TCG não escreve nem modifica código, não gera nem aplica patches, não escolhe estratégia de implementação e não é um agente de programação. O fluxo é outro: o repositório passa pelo TCG, o TCG entrega um mapa estruturado, o LLM consulta esse mapa, raciocina e altera o código, e a alteração leva a uma nova análise que registra um novo snapshot. A fronteira entre as duas metades não é detalhe de implementação. Ela define que tipo de erro pode existir em cada lado. Se o mapa estiver errado, o defeito é do TCG e pode ser reproduzido, porque a análise é determinística. Se a mudança estiver errada sobre um mapa correto, o defeito é do raciocínio. Quando as duas coisas vivem no mesmo componente, essa distinção desaparece, e o diagnóstico vira arqueologia de prompt.
Separar fato de raciocínio é, no fundo, separar o que pode ter contrato do que não pode. Um componente determinístico pode prometer que a mesma entrada produz a mesma saída, que cada fato carrega sua origem e que nada foi reindexado sem motivo. Um LLM não pode prometer nada disso, e não deveria ser cobrado por isso. Prefiro que a parte probabilística do sistema fique inteira no lugar onde a incerteza é esperada, e que a parte que alimenta essa incerteza seja tão auditável quanto um compilador. Pelo mesmo motivo, o TCG não é uma extensão do ESAA, que já discuti bastante aqui. São projetos independentes. Um mapa estrutural do código precisa responder sobre o código, qualquer que seja o processo que o agente segue para mudá-lo, e acoplá-lo a um protocolo de execução seria repetir, em outra escala, a mistura que o TCG existe para evitar: quem informa passaria a depender de quem decide.
Declarar o que não se sabe faz parte do invariante
A decisão que mais me custou foi sobre o silêncio. Um mapa estrutural sempre tem buracos. Em Python e TypeScript, parte das relações depende de despacho dinâmico ou de construções que a análise estática não resolve com segurança. Em qualquer linguagem, o suporte a chamadas pode não existir para um caso, e um provider pode estar ausente no ambiente. A pergunta é o que o mapa faz com esses buracos. A resposta fácil é omitir: listar o que foi encontrado e deixar o resto em branco. O problema é que, para um agente, uma lista de três chamadores é lida como «existem três chamadores». A omissão vira afirmação negativa sem que ninguém tenha afirmado nada.
Por isso a saída do TCG mostra de onde vem cada fato, a qual snapshot ele pertence, o que está resolvido e o que não pôde ser determinado. Ausência de relação identificada não é garantia de inexistência, e o contrato diz isso explicitamente em vez de deixar que o consumidor infira o contrário. Uma consulta de impacto entrega relações e proveniência, não previsão absoluta de comportamento. Pode parecer ressalva jurídica. Para mim é o invariante central: um fato sem origem e sem snapshot não é fato, é boato estruturado, e uma lacuna não declarada é pior que uma lacuna declarada, porque transfere ao LLM a decisão de tratar o desconhecido como vazio. O agente pode decidir mal com um mapa honesto. O que ele não deveria é decidir mal porque o mapa se calou.
O snapshot merece um parágrafo à parte. Como o LLM altera o código e o TCG reanalisa depois, todo fato tem validade datada. Uma referência que existia antes da alteração pode não existir depois, e uma que não existia pode ter surgido. Amarrar cada resposta a um snapshot é o que impede o agente de raciocinar sobre o repositório de dez minutos atrás como se fosse o de agora, e é o que torna possível perguntar, depois de uma mudança, o que mudou na estrutura e não só no texto.
O que a rodada de estabilização mostrou
A v0.1.0 é experimental e suporta Rust, Python e TypeScript. C e PHP ficam para o futuro. Na rodada de estabilização, o candidato passou nas três aplicações reais em que foi testado: três reconstruções equivalentes por aplicação, duas consultas de impacto aprovadas por aplicação, e um warm no-op que não fez nenhuma reindexação. Leio esses três critérios como testes de contrato, não como métricas de desempenho. Reconstruções equivalentes testam o determinismo, que é a condição para que um erro no mapa seja reproduzível. Consultas de impacto aprovadas testam se o mapa responde o que o agente precisa perguntar. O warm no-op testa uma propriedade menos vistosa: se nada mudou no repositório, nada deve ser recalculado. Um sistema que reindexa sem motivo não está só gastando tempo; está sinalizando que não sabe exatamente o que depende do quê, que é justamente o que ele promete saber.
A regressão completa ficou em 252 PASS, 5 FAIL e 0 ERROR. Quatro dessas falhas vêm de providers ausentes no ambiente. A quinta é uma regressão real, em test_nonpropagating. O resultado oficial é RELEASE_BLOCKED. A versão não foi lançada e não existe repositório público.
Eu poderia descrever isso como «quase pronto», e o número convida: 252 contra 5 parece margem confortável. Mas o gate de release não mede margem. Ele mede se algum invariante foi violado, e um foi. Quatro falhas de ambiente são informação sobre o ambiente; uma falha real é informação sobre o sistema, e misturar as duas na mesma contagem seria cometer, no processo de release, o erro que o mapa se recusa a cometer na consulta. Um projeto cujo argumento inteiro é não transformar desconhecido em ausência não pode, na hora de se lançar, tratar uma regressão conhecida como ruído estatístico. Se eu relaxasse o critério aqui, estaria ensinando ao próprio TCG a mentira que ele foi construído para não contar. O bloqueio é o sistema funcionando.
Por que embrionário é a palavra certa
Considero o TCG embrionário, e não por precaução retórica. Três linguagens, três aplicações reais e uma regressão aberta descrevem um projeto que já tem forma, mas que ainda não provou seu contrato fora do lugar onde nasceu. O que eu tenho é uma fronteira bem desenhada e evidência inicial de que ela se sustenta. O que eu não tenho é uso amplo, diversidade de repositórios, nem um histórico que mostre como o mapa se comporta diante de código que eu nunca vi.
A fronteira, porém, me parece a parte que não vai mudar. Agentes de programação vão continuar melhorando no raciocínio, e justamente por isso precisam de um chão que não raciocine: algo que diga o que existe no código, de onde veio essa informação, quando ela foi observada e onde ela termina. A qualidade de uma mudança feita por um LLM depende menos de quanto o modelo sabe sobre programação do que de quanto ele consegue distinguir, no repositório à sua frente, o que foi visto do que foi suposto.